Post
让 Agent 主动推进工作:构建事件驱动的 Agent Runtime
从人肉调度转向 Runtime 调度,以一个负责的工程师如何工作为切入点,探讨 Agent 主动性的三个系统支点、确定性调度底座,以及通过轻量决策模型破局语义调度的实践探索。
让 Agent 干活,很多人的第一体感就是“推一下动一下,不说就不动,眼里没活”。
这个问题很多人小时候做家务时大概都被家长数落过:“油瓶倒了也不知道扶一下”。
现在做 Agent,大家都在大谈主动性(Autonomous),在 System Prompt 里写满“你要有始有终”、“主动推进交付”。但只要你关掉对话窗口,它立刻就停在那里;一旦离开人的持续催促,事情就无法闭环。
想让 Agent 主动去扶“油瓶”,核心从来不是在 Prompt 里写满心理暗示,而是三个最基础的系统前提:
- 明确的长期职责:它得知道扶油瓶属于自己的岗位分工,而不是等别人临时指派;
- 外部事件感知:它得能及时感知到“油瓶倒了”这个外部事件,而不是靠后台盲目轮询;
- 持久的工作状态:它得有独立于单次会话的工作记录,知道扶完放哪、遇到阻碍怎么交接。
如果承载 Agent 的系统没有保存未完成工作的状态,也没有在外部条件变化时恢复执行的机制,模型再聪明,人也依然要充当它的“肉身调度器”。
这篇文章要解决的核心工程问题是:怎样从人肉调度转向 Runtime 调度,用事件驱动架构,让 Agent 跨过单次对话的边界,持续推进一件事?
为什么人反而成了 AI 的调度器
很多人用 Agent 写代码,都会遇到类似的情况。
让它重构一个模块,它很快分析代码、修改实现、补上测试,再提交一个 PR。到这里,单次交互的体验已经很好了。但从工程交付的角度看,工作才刚刚开始。
CI 还在跑,Review 可能提出新问题,发布需要审批。即使部署成功,也要确认实际部署的版本,检查关键路径有没有回归。这些环节往往跨越几十分钟甚至数天,绝不可能在单次会话里连续发生。
于是,人必须不断回来充当“人肉闹钟”:“CI 过了吗?”“那个意见处理了吗?”“发布后检查了吗?”
模型负责了最显眼的代码修改,人却接手了那些最繁琐、但决定事情是否闭环的调度协调工作。代码是 AI 写的,什么时候回来、回来后接着做什么,却全靠人盯着。
聊天系统以会话为中心,而真正的协作必须以工作为中心。 两者的分水岭非常明确:一次模型交互结束后,工作是否拥有独立于上下文窗口的目标、进度与恢复条件。
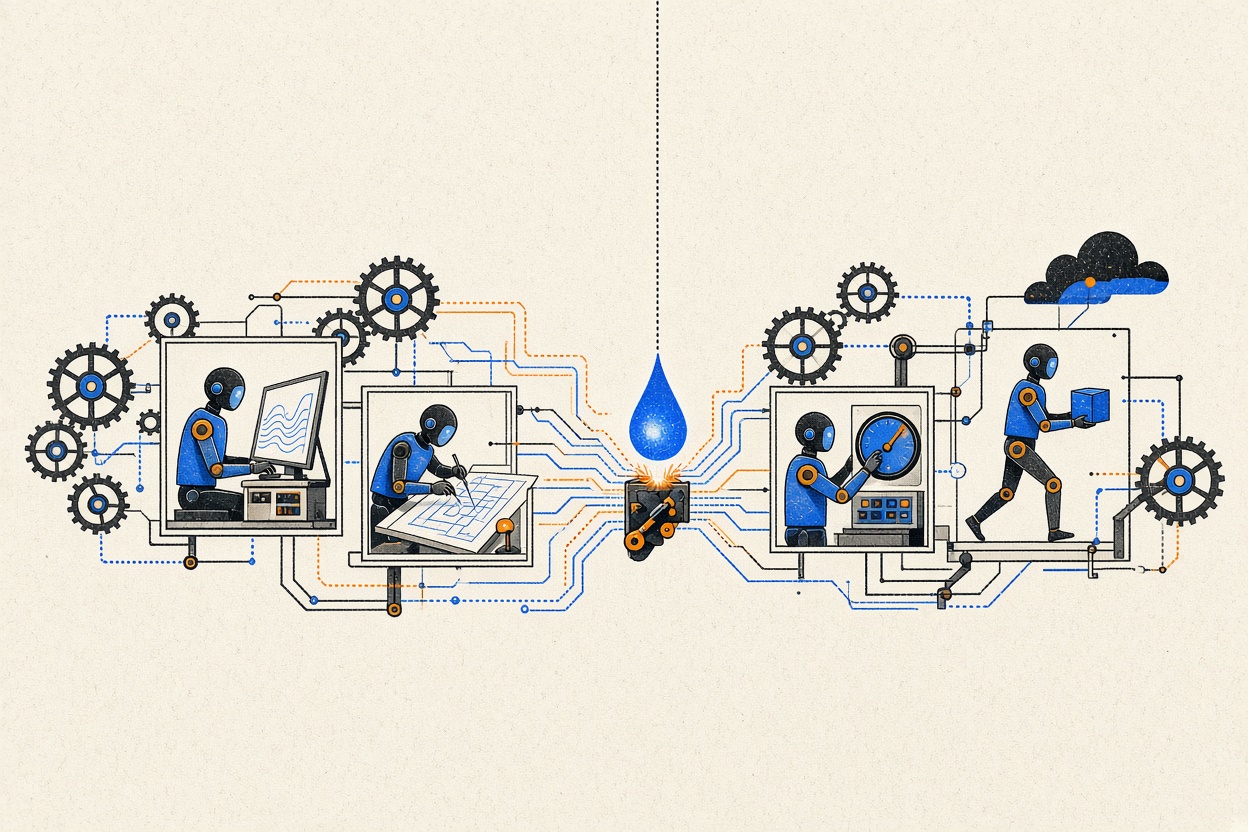
Prompt 可以说明职责,聊天记录可以保留讨论,但它们无法替代运行时的调度机制。让 Agent 主动工作的关键,就是把这部分“人肉调度”交给 Runtime——由系统来管理哪些工作可以推进、哪些正在等待、什么变化值得唤醒,以及恢复时带回哪些工作记录。
人负责定义目标、作出关键审批、验收最终结果,但不应该充当每一次操作之间的“继续”按钮。
Agent 主动性的三个系统支点
一个负责的工程师之所以“眼里有活”,不是因为他每分每秒都在敲键盘,而是把一件事交给他之后,不用别人不断追问下一步。对照这种工作方式,系统需要提供三个核心支点。
1. 长期职责:让 Agent 拥有岗位与积累,而不是临时函数
Agent 应当是长期承担职责的协作者,而不是每次请求时临时构造的函数。
这就要求 Agent 拥有自己的独立存储空间和长效工作约定。在 Holon 中,每个 Agent 都有一个专属的 Agent Home:
notes/保存长期背景与经验;skills/保存它掌握的工作技能;AGENTS.md则是它的长效工作契约,定义了角色分工、默认行为原则与权限边界。
更重要的是将身份(Identity)、工作项(WorkItem)与单次执行(Turn/Activation)彻底解耦:
- 身份(Identity):定义长期职责与权限约定(比如“代码审阅者”);
- 工作项(WorkItem):承载具体的目标、交付物与生命周期(比如“修复 Issue #328 的内存泄漏”);
- 执行轮次(Turn/Activation):只是系统分配给该工作项的一次临时计算机会。
一次执行结束了,工作项并没有结束;工作项完成了,Agent 的身份依然长期存在。
2. 外部事件感知:等待是常态,唤醒靠事件驱动
在真实的软件工程交付中,等待才是常态,执行只是偶发。
一次提交可能只需要几十秒,但等待 CI 结果需要 15 分钟,等待同事 Review 需要半天,等待发布审批可能需要跨越整个周末。如果要求 Agent“主动推进”,却把等待实现为长连接挂起、内存 Future 挂起,或者后台死循环轮询,系统很快就会崩溃在资源消耗与网络中断里。
等待必须成为运行时的一等公民。当 Agent 发出等待(比如等待 CI 结果),当前轮次必须能立刻安全终结,上下文完整落盘,系统资源清零。
直到外部 Webhook、CI 回调或操作者输入到来时,事件总线才精准定位到对应的等待项,将 Agent 重新唤醒。只有这样,“主动性”才具有工程上的可持续性。
3. 持久工作状态:被叫回来之后,知道从哪里接着做
光有事件把 Agent 唤醒还不够。如果每次醒来都要重新问一遍“我是谁、刚才干到哪了”,就等于把上下文又推回给人。
这就需要有独立于会话上下文的持久工作载体——WorkItem。它记录的不是聊天摘要,而是一套完整的任务档案:
- 明确的目标与验收标准;
- 当前的执行计划与 Todo 清单;
- 代码改动、测试日志与产物引用;
- 当前挂起的原因(正在等待什么外部条件)。
当事件唤醒 Agent 时,运行时重新组装这些结构化状态。Agent 睁开眼就能确认:“CI 已经通过,我上次停在部署前检查,下一步该申请发布审批了”。它接续的是同一件尚未完结的工作,而不是展开一段没有由来的新聊天。
确定性调度底座:状态机、挂起与并发栅栏
要支撑上述机制,Runtime 必须先建立一套坚固的确定性调度底座。
这里的“确定性”,是指系统的工作流转、状态变迁与等待规则必须完全受控,有明确的因果关系,绝不能把系统生命周期交由大模型临场猜测。
1. 显式状态机:拒绝模糊的标志位
在很多早期的 Agent 实验中,大家往往用几个松散的布尔值或“空闲/忙碌”这样简单的状态来管理 Agent。但在复杂的工程场景下,工作流的状态远比这丰富。
在系统的调度核心中,一个工作项(WorkItem)的状态迁移被严格约束为一个显式状态机:
pub enum WorkItemSchedulingState {
    Runnable,           // 就绪可运行
    YieldedToWorkItem,  // 让渡给子任务,等待子任务交付
    WaitingOperator,    // 等待操作者输入/审批
    WaitingTask,        // 等待后台长时间任务结果
    WaitingExternal,    // 等待外部 Webhook/Ingress 事件
    WaitingTimer,       // 等待持久定时器到期
    WaitingSystem,      // 等待系统级信号
    Blocked,            // 遭遇独立业务依赖阻塞
    Completing,         // 正在提交最终验收产物
    Completed,          // 目标达成,正式终结
}
显式状态机带来了两个核心优势:
- 精确区分让渡与阻塞:让渡(
YieldedToWorkItem)代表主动将执行权交给子任务,子任务完成后自动恢复;而Blocked则代表遭遇了硬性依赖。 - 等待来源类型化:不同类型的等待(任务、外部事件、定时器、人工审批)有截然不同的恢复条件与超时策略,杜绝了散落在各处的
if/else脏状态。
2. Reactor 挂起与持久化契约:等待不是阻塞线程
在长期协作场景中,等待往往跨越数小时甚至数天。
系统不能在内存里挂一个悬空的异步任务,更不能开一个后台线程在那里 sleep 轮询:内存结构在系统重启或部署时会瞬间灰飞烟灭,线程阻塞则是对系统资源的极大浪费。
运行时必须借鉴操作系统 Reactor 模式:
pub enum WakeSource {
    TaskResult { task_id: String },
    ExternalIngress { external_trigger_id: Option<String> },
    Timer { wake_at: DateTime<Utc> },
    OperatorInput,
    SystemTick,
}
当 Agent 触发 WaitFor 时,当前执行轮次安全退出,带有接续上下文(Continuation)和唤醒源(WakeSource)的等待记录被原子写入持久化数据库(SQLite)。此时系统内存与 CPU 消耗归零,不占用任何线程,也不消耗大模型 Token。
直到外部事件真正投递,Runtime 才会将该记录重新捞起并推入可运行队列。
3. 并发安全与版本栅栏:防止幽灵唤醒与脏重入
在真实的异步网络世界中,外部重试、网络延迟与高并发是常态:
- 一个等待已经超时、被人工取消或已被前序操作消费,外部系统的重试 Webhook 却姗姗来迟,会不会让已经死亡的等待甚至已关闭的任务“起死回生”?
- 任务在让渡期间内部状态已经推进,延迟到达的旧唤醒会不会让 Agent 带着过期的假设发生脏重入,覆盖最新结果?
如果缺乏并发与生命周期控制,这类迟到或重试的消息就会引发幽灵唤醒(Phantom Wake)与脏重入。
这些问题在系统底层通过版本栅栏(Version Fence)进行硬性防护:
- 等待世代与失效防护:每个等待槽位(WaitSlot)具有严格的生命周期与世代。事件到达时,Runtime 会严格划分为精确匹配(
Match)、陈旧失效(StaleExact)与二义性冲突(Ambiguous)。对于已取消、超时或已被消费的等待,即便带着对应的等待标识到达,也会被作为陈旧失效直接拦截,决不允许失效等待死灰复燃; - 工作项版本锁:每个工作项带有单调递增的修订版本号(Revision),唤醒后的状态恢复与提交必须校验 Revision 的绝对一致性,拦截基于失效快照做出的任何状态变更;
- 事务性状态跃迁:从事件匹配、消息入队到状态转移,全流程都在单个数据库事务中原子完成,确保高并发事件冲击下状态机依然保持绝对自洽。
4. AgentInbox:独立事件归集服务,化解消息投递风暴
解决了挂起与幽灵唤醒,外部事件接入还会面临另一个棘手的工程痛点:消息投递风暴(Message Storm)。
以一个正在审查的 GitHub PR 为例,外部事件往往是接连不断的:代码推送、静态检查、多阶段 CI 状态更新、多位评审者的逐行评论。如果系统每收到一个事件就立刻唤醒 Agent,把原始消息塞进当前对话上下文,不仅会迅速挤爆上下文窗口,更会粗暴打断 Agent 正在进行的推理与验证链路。
解决这个问题的关键,不能指望 Agent Runtime 自身去硬编码各种外部平台的连接器(Connector)。我在架构上将这层职责拆分出来,实现了一个独立的本地事件流归集与激活服务 —— AgentInbox(开源仓库:github.com/holon-run/agentinbox)。
AgentInbox 介于外部系统与本地 Agent Runtime 之间:
- 统一接入与流持久化:外部源(GitHub、飞书、Webhook 等)只与 AgentInbox 对接,事件被统一存为持久化事件流(Durable Event Stream),支持多 Agent 按需订阅路由;
- 解耦通知提醒与具体内容:
外部系统(GitHub / CI / 飞书)
           ↓
   AgentInbox(独立事件服务)
     - 统一事件流存储
     - 订阅路由与防风暴缓冲
           ↓ (轻量 Trigger 唤醒)
   Agent Runtime(如 Holon)
           ↓ (安全点主动拉取详情)
   Agent 结合当前任务状态机推进
在这个架构下,有两条关键原则:
- 合并的是通知,不是把原始消息逐条塞进对话:AgentInbox 负责在外部事件高频冲击时提供缓冲,通知 Runtime“有待处理的新动态”,而不是替 Agent 预先总结或者粗暴拼接内容。Agent 在执行的安全间隙,按需主动向 AgentInbox 拉取事件详情并进行确认(Ack)。
- 知道有变化,不等于赋予新指令权限:从外部拉取的内容依然属于待核验的输入,绝不能因为它是新消息,就自动成为具备操作权限的最高指令。
语义调度深水区:小决策模型的破局
确定性调度解决了“骨架与执行秩序”的问题:它能保证工作可以可靠地挂起、安全地唤醒、不错乱地流转。
但很快,系统就会撞上它的天花板:能接着做,不等于知道此刻该先做什么。
1. 确定性调度的天花板:静态规则算不出上下文语义
回到工程师的工作场景:日程表可以提醒他开会,看板可以列出待办,CI 会通知他构建失败。但他收到一条消息时,是否应该立刻放下手头正在写的重构方案?这完全取决于消息的内容与当前任务的语义关联。
在 Agent Runtime 里,单纯依赖状态码和固定规则,很难回答以下几个核心难题:
- 插入还是排队:外部事件(如 GitHub Issue 评论)到来时,应该立即打断(Interject)当前正在执行的轮次,还是作为普通消息排入队尾?
- 关联哪项工作:系统并发维护多个工作项时,这条 Webhook 究竟属于正在重构的模块 A,还是刚才提交的 Bug 修复 B?
- 该不该唤醒:Agent 处于休眠或空闲状态时,新到来的系统通知是一次无关紧要的信息同步,还是紧急到必须立即唤醒?
- 过期结果要不要处理:执行超时或取消后的后台任务返回了结果,是直接丢弃,还是保留其中的关键诊断证据?
这些问题不是简单的状态码比对或枚举检查,而是需要理解代码上下文、任务目标和事件内容的语义判断。
2. 两次碰壁与决策模型(Decision Model)的破局
为了让系统具备语义调度能力,我先后尝试过两种途径:
- 直接调用主力 LLM:延迟高、成本高。调度属于高频运行循环,主力大模型的响应延迟会让系统极度迟钝,持续消耗的 Token 成本在工程上也无法承受。
- 自训练轻量分类器:虽然规避了延迟和成本,但泛化能力不行,面对千奇百怪的代码上下文很难稳定工作。
直到后来测试了 Jev 等轻量决策模型(Decision Model),这个困扰才真正迎刃而解。
决策模型的定位与通用生成式大模型截然不同:它不负责写长篇代码,核心使命是在给定的合法选项中做极速、高精度的判决选择。它的延迟只有几十毫秒,成本极低,同时又保留了基础语言模型的语义理解能力——能读懂“这个测试失败直接推翻了当前重构假设”。
接入决策模型作为 Advisory Decision Provider 后,语义调度终于跑顺了:事件到达时,Runtime 提取工作项目标与事件摘要,交给决策模型做选择题(Interject / QueueNext / Ignore),几十毫秒内得出判定,系统在下一个安全点精准分流。
3. 关键原则:决策模型提供建议,Runtime 拥有最终权限
引入语义决策模型,绝不意味着把系统的控制权全盘交出。这里必须确立一条铁律:
决策模型产生的是参考建议(Advisory Evidence),Runtime 拥有绝对的裁决权与硬安全边界。
大模型在语义理解上极强,但在系统安全和权限边界上天生是“软性”的。你绝不能寄希望于在 Prompt 里约束模型“不要越权”。
在系统的调度架构中,决策流程是单向且受控的:
       外部事件到达
            ↓
Runtime 过滤非法选项,准备合法候选集
            ↓
决策模型给出选项建议(或显式弃权)
            ↓
Runtime 在采用前重新核验(版本、权限、租期)
            ↓
合法则按建议转移状态;超时/失效则退回确定性规则
决策模型永远无法直接操作状态机,更无法提升权限。哪怕模型被外部恶意注入诱导选择非法项,Runtime 底层的类型检查与状态栅栏也会直接将该建议驳回。
确定性底座负责守住安全的底线,语义决策模型负责拔高协作的灵活性,二者各司其职。
真实环境下的运行验证
这些架构设计不是纸面推演,而是在真实环境长期运行中沉淀下来的。
很多人对长生命周期 Agent 的认知容易走向两个极端:要么是每次对话都要重新交代背景的单次 ChatBot,要么是无休止空转、持续消耗 Token 的死循环脚本。
我们通过两个截然不同的真实场景,来检验这套事件驱动 Runtime:
- 个人多 Agent 单节点:验证状态机挂起、多身份并存、事件待命与长任务承载能力;
- 四人全功能团队协同:验证多角色 Agent 融入真实工程流水线的人机接力。
案例一:个人多 Agent 节点——58 个常驻身份的分工协同与事件待命
场景与运行环境:远程 Linux 专属开发工作站
很多人好奇:单人如何有效管理和运转几十个 Agent?这里的关键场景在于——它不是跑在随开随合的个人笔记本或临时桌面客户端里的辅助插件,而是一台 24 小时在线的远程专属 Linux 开发工作站:
- 硬件配置:AMD Ryzen Threadripper PRO 3975WX(32 核心 64 线程)、128 GB 内存、Ubuntu 22.04 LTS;
- 接入与交互模式:日常开发中,我通过轻薄笔记本上的 Web 工作台或命令行工具远程连接至该节点;
- 任务与状态驻留:所有的 Agent 身份状态、持久化 WorkItem、独立的 Git Worktree 隔离工作区,以及重度的代码本地编译与自动化测试,全部常驻并执行在这台远程主机上。
强大的多核与大内存为多 Agent 并行构建、环境隔离提供了坚实的物理算力底座;但更重要的是,如果没有事件驱动的挂起与状态机调度,即便是 64 线程、128G 内存的工作站,也会迅速被几十个 Agent 的轮询死循环或资源泄露拖垮。正是依靠“未唤醒即冻结挂起、零 Token 消耗、按需激活”的机制,单节点才能在 128 天里长期平稳运转。
根据节点运营分析工具(holon-growth)对 128 天(2026 年 6 月初至 10 月中旬)真实运行历史的统计:
- 运行规模:节点共管理 58 个可见 Agent,其中 56 个留存了实际执行记录;累计完成了 61,973 个已终结的有效轮次;
- 执行时长:各 Agent 执行时长累计相加达 2,985.6 小时,节点跨 Agent 去重后的实际忙碌时长为 1,534.5 小时;
- 并发与突发:记录还原的单节点峰值并发达到 15 个 Agent 同时活跃;单日最高并发去重忙碌达 21.47 小时(各 Agent 时长相加达 73.97 小时,单日 19 个 Agent 协同运转)。
差异化的 Agent 职能生态矩阵
一个人为什么需要几十个 Agent?因为在长生命周期架构下,每个 Agent 对应一个确定的职责边界与触发源,网页端的大画布正好能展现这套完整的协作谱系:
| Agent 身份 | 职责定位 | 典型唤醒事件与协作模式 |
|---|---|---|
holon-dev / holon-dev2 | 核心系统研发 | 长程任务攻坚。由任务分配唤醒,独占 Git Worktree 编码、本地构建、测试回归与 PR 提交,跨天接续工作项(累计执行超 500 小时,9,600+ 轮次)。 |
holon-reviewer | 代码审阅 | 事件响应型。由 PR 提交或更新事件唤醒,快速做增量代码审查与风险把关,完成后立刻归还控制权(累计执行超 320 小时,近 9,000 轮次)。 |
holon-qa | 测试与质量保障 | 由新版本构建或集成事件唤醒,负责测试套件回归、跨版本兼容性验证与用例排查。 |
holon-release | 版本发布交付 | 由发布流程事件触发,负责版本流水线编排、跨平台制品归档校验与 Release 文档同步。 |
holon-ops | 日常运维巡检 | 低频高敏常驻。由定时器或告警事件唤醒,负责巡检、依赖健康与状态维持,平时绝不消耗算力。 |
holon-growth | 运营与数据分析 | 负责技术生态数据采集、节点运行指标统计分析(包括本文引用的这组数据)与发布材料整理。 |
email-assistant | 邮件与信息助理 | 外部通知与邮件事件过滤,快速响应处理碎片化信息,提炼待办事项。 |
agent-ecosystem-researcher | 专题技术调研 | 负责长程资料抓取、竞品演进跟踪与深度技术分析,输出结构化研究报告。 |
minecraft-ai-researcher | 具身长任务攻坚 | 具身环境长程自主闭环,验证高频交互与复杂状态机在极限场景下的稳定性。 |
运行节律:日常待命与长程突击
不同职责的 Agent,在真实环境中的运行节律截然不同。下面是 2026 年 7—9 月四个代表性角色的跨月统计(每格为“有执行记录的天数 / 当月累计执行小时”,单个 Agent 内的重叠区间已去重):
| Agent / 职责 | 2026 年 7 月 | 2026 年 8 月 | 2026 年 9 月 |
|---|---|---|---|
holon-dev / 研发 | 31 天 / 159.3 h | 26 天 / 81.6 h | 30 天 / 154.7 h |
holon-reviewer / 审阅 | 30 天 / 32.9 h | 28 天 / 48.0 h | 30 天 / 135.1 h |
holon-ops / 运维 | 23 天 / 13.7 h | 23 天 / 21.8 h | 28 天 / 46.1 h |
minecraft-ai-researcher / 具身长任务 | — | 7 天 / 15.5 h | 18 天 / 114.2 h |
这组对比体现了事件驱动 Runtime 的核心价值:
- 研发 Agent 持续在岗:三个月内有 87 天都在参与工作,依靠持久状态和独立 Worktree 推进复杂的工程演进,不需要每天复制一段 Prompt 重新告诉它上下文;
- 运维 Agent 绝对静默:在 9 月有 28 天在岗,但执行日时长中位数仅有 1.15 小时。它的大多数时间都处于静默休眠状态,只有告警或定时巡检到来时才被唤醒,做完立刻交出控制权,绝不空转浪费算力;
- 审阅 Agent 紧随节奏:按 PR 提交的节奏被动介入,全天候随叫随到,没有 PR 时毫无存在感;
- 具身任务突破长程极限:具身 Agent 在 9 月单日最高净执行长达 16.02 小时、自主闭环完成 1,933 轮交互(自主伐木平整、精确建造 7×5×4 双层木屋、合成床跳过黑夜并在夜间战斗自卫)。这证明只要状态挂起与轮次恢复足够确定,Agent 完全有能力胜任高强度长程任务。
它们不需要每天重新建立身份,也不需要靠持续输出内容来证明自己“在线”。在等待外部条件满足的漫长间隙里,系统始终保持绝对的静默与可靠。
案例二:四人研发团队实践——调查、审阅与验收的工程接力
如果说单节点的 58 个 Agent 验证了单机并发与状态机健壮性,那么在真实团队中,事件驱动的 Agent 则展现了作为全天候“数字同事”的人机接力能力。
在这个场景中,系统的部署与协作形态与常见的“团队版 ChatGPT”有着根本区别:
- 直连基础设施与内网环境:系统直接部署在团队的核心服务器上,与服务器环境、内部数据库、日志系统和监控打通。因此,Agent 不仅能看代码,还能承担服务器日常运维、线上监控排查、即时数据查询与统计等直接接触内网资产的工作,不需要人工把日志拷出来喂给网页端;
- 全局共享与连续上下文,而非隔离会话:团队成员通过 OIDC(如单点登录)接入同一套工作台。所有成员看到的 Agent 列表是完全相同且全局共享的。与普通 AI 产品中“每个人开自己的 private session、上下文互相割裂”不同,在这里,任何成员在 Agent 中触发的排查、生成的 WorkItem 或留下的上下文,全团队都能实时看到连续的记录与进展。Agent 是团队共同资产,而不是各自手里的私有玩具。
在这样一个包含 Android、iOS、产品兼市场、测试的 4 人全功能小团队中,这批共享 Agent 深度嵌入了日常协作流水线。在连续 77 天的统计窗口内,累计覆盖了:
- 858 个 Issue 的前期排查与背景调查;
- 1,217 次 PR 的正式增量审阅;
- 652 个 Issue 的功能验证与验收测试。
比宏观数字更能说明价值的是具体的协作细节:
- 日志调查自动切入:当用户报告“点击查看完整曲谱无响应”时,Agent 自动根据报错从日志切入调查,并将调用链路与疑点直接写回 Issue,后续工程师接手时无需从零开始复现;
- 软硬件边界分工明确:当遇到“琴键亮了却没有声音”这类软硬件交互问题时,人工完成真机测试,Agent 汇总代码提交、CI 结果与已有反馈,把各自擅长的事交给最合适的主体。
这就是团队协作的核心价值:让调查、修改、审阅和验收之间拥有可接续的上下文记录,大幅减少人肉搬运信息的系统摩擦。
结语:从“批处理问答”走向“中断驱动的操作系统”
回到最初的问题:我们到底需要什么样的 AI 主动性?
如果回顾计算机演进史,今天绝大多数人使用大模型的方式,与早期计算机的单任务批处理惊人地相似:人在聊天窗口喂一段 Prompt,模型吐出回复;人关掉窗口,一切状态随之清空。在这种单次会话模式下,一旦需要跨时间推进复杂工作,人就不得不沦为“人肉调度器”与“人工轮询器”。
操作系统的真正质变,不在于 CPU 主频的飙升,而在于硬件中断机制(Interrupt)与进程状态机的引入——未就绪时安全挂起,事件到达时精准唤醒。今天大语言模型已经展现出惊人的推理与编码能力,在本质上扮演了新时代的“认知 CPU”;但要让它真正成为独立承担职责的数字同事,系统演进的瓶颈早已不在模型参数本身,而在于缺少一套面向认知实体的现代 Agent Runtime 操作系统内核。
从“人肉调度”走向“Runtime 调度”,是把人类从脆弱的机械搬运与上下文接力中彻底解放出来。
当外界环境改变、“油瓶倒了”那一刻,事件总线自然触发中断;Agent 迅速从休眠中被唤醒,知道该扶、并在扶完之后准确记录归位,然后再次安然挂起——只有当底层的 Agent Runtime 完成了这一范式跨越,我们才算真正拥有了能够独立承担工作的数字协作者。
相关项目与参考链接
- 开源项目:
- Holon(github.com/holon-run/holon):长生命周期、工作项驱动的开源 Agent Runtime(官网与文档:holon.run)。
- AgentInbox(github.com/holon-run/agentinbox):面向 Agent 的本地事件流归集与激活服务。
- 延伸阅读与实践:
- 《从个人 AI 工具到团队协作:一个小团队的 Agent Native 实践》:小团队中共享 Agent 参与 850+ Issue 调查与 1,200+ PR 审阅的真实运行数据与落地总结。
- 《不止审一次代码:用 Holon 搭建持续跟进 PR 的 Reviewer》:关于长生命周期 PR 跟进与事件唤醒的具体实践。
- 《给 Agent 调度系统加一个小决策模型》:早期探索 Jev 与轻量决策模型破局语义调度的思考记录。
- 《Holon 是什么,以及我为什么要做 Holon》:关于为什么需要独立工作状态与 Runtime 调度的背景初衷。
- 交流与反馈: